2026年2月19日
麻省理工學院建設性溝通中心的研究發現,對於英語程度較低、教育程度較低、非美國籍的用戶,領先的人工智慧模型表現較差。
大型語言模型(LLM)一直被譽為能夠實現全球資訊民主化獲取的工具,無論使用者的背景或地理如何,都能透過使用者友善的介面獲得知識。然而,麻省理工學院建設性溝通中心(CCC)的一項新研究表明,這些人工智慧系統實際上可能對那些最能從中受益的用戶而言表現更差。
麻省理工學院媒體實驗室下屬的CCC的研究人員進行的一項研究發現,包括OpenAI的GPT-4、Anthropic的Claude 3 Opus和Meta的Llama 3在內的最先進的人工智慧聊天機器人,有時會對英語水平較低、受教育程度較低或來自美國以外的用戶提供不太準確、不太真實的回應。這些模型拒絕回答這些使用者問題的機率也更高,在某些情況下,它們的回應還會帶有居高臨下或盛氣凌人的語氣。
「我們希望LLM計畫能夠幫助解決全球資訊獲取不均的問題,」論文第一作者、麻省理工學院斯隆管理學院技術助理埃莉諾·普爾-戴安(Elinor Poole-Dayan SM '25)說道。她曾是CCC成員,也是媒體藝術與科學的碩士研究生,並領導了這項研究。 “但是,如果不確保模型偏差和有害傾向能夠安全地減輕所有用戶(無論其語言、國籍或其他人口統計特徵如何)的負擔,這一願景就無法實現。”
一篇描述這項工作的論文「LLM 針對性性能不足對弱勢用戶造成不成比例的影響」於 1 月在 AAAI 人工智慧大會上發表。
多維度系統性表現不佳
在這項研究中,研究團隊測試了三個語言學習模型(LLM)對兩個資料集的問題的回答:TruthfulQA 和 SciQ。 TruthfulQA 旨在衡量模型的誠實度(透過依賴關於現實世界的常見誤解和字面意義上的真理),而 SciQ 則包含測試事實準確性的科學考試題。研究人員在每個問題前面都添加了簡短的使用者簡介,這些簡介包含三個不同的特徵:教育程度、英語程度和國籍。
研究人員在所有三個模型和兩個資料集上都發現,當提問者被描述為教育程度較低或英語非母語者時,準確率顯著下降。這種影響在同時符合這兩個條件的用戶身上最為明顯:教育程度較低且英語非母語的用戶,其回答品質下降幅度最大。
該研究也檢視了使用者來源國如何影響模型表現。研究人員測試了來自美國、伊朗和中國、教育背景相同的用戶,發現 Claude 3 Opus 模型在兩個資料集上對伊朗用戶的表現都明顯更差。
「我們發現,對於非英語母語且教育程度較低的使用者而言,準確率下降幅度最大,」CCC 研究科學家、論文的合著者 Jad Kabbara 表示。 “這些結果表明,模型行為對這些用戶特徵的負面影響會以令人擔憂的方式疊加,這表明大規模部署此類模型存在將有害行為或錯誤信息傳播給最難識別這些行為或信息的人群的風險。”
拒絕和居高臨下的語言
或許最引人注目的是模型完全拒絕回答問題的頻率差異。例如,對於教育程度較低、非英語母語的用戶,Claude 3 Opus 拒絕回答的問題比例接近 11%,而對照組(沒有用戶簡介)的拒絕回答比例僅為 3.6%。
研究人員手動分析這些拒絕資訊後發現,對於受教育程度較低的用戶,Claude 有 43.7% 的機率使用居高臨下、盛氣凌人或嘲諷的語言進行回應,而對於受教育程度較高的用戶,這一比例不到 1%。在某些情況下,該模型還會模仿蹩腳的英語或採用誇張的方言。
該模型還拒絕向來自伊朗或俄羅斯等教育程度較低的用戶提供某些特定主題的信息,包括有關核能、解剖學和歷史事件的問題——儘管它對其他用戶提出的相同問題都能正確回答。
卡巴拉說:“這又是一個跡象,表明對齊過程可能會激勵模型向某些用戶隱瞞信息,以避免可能誤導他們,儘管模型顯然知道正確答案並提供給其他用戶。”
人類偏見的迴響
研究結果與已記錄的人類社會認知偏誤模式相吻合。社會科學研究表明,以英語為母語的人往往會認為非英語母語者受教育程度、智力和能力較低,而不管其實際專業程度如何。教師在評估非英語母語學生時也有類似的偏見。
「大型語言模型的價值體現在其極高的普及率和大量湧入該技術的投資上,」媒體藝術與科學教授、CCC主任、該論文的合著者黛布·羅伊(Deb Roy)表示,「這項研究提醒我們,持續評估那些悄然滲入這些系統的系統性偏見至關重要,這些偏見會在我們所有人渾然不覺的情況下,對某些群體造成不公平的傷害。
鑑於個人化功能(例如 ChatGPT 的「記憶」功能,該功能可以跨對話追蹤使用者資訊)正變得越來越普遍,其影響尤其令人擔憂。此類功能有可能對本已處於邊緣地位的群體造成差別對待。
「學習資源管理工具(LLM)一直被宣傳為能夠促進更公平的資訊獲取並革新個人化學習的工具,」Poole-Dayan說。 “但我們的研究結果表明,它們實際上可能會加劇現有的不平等,因為它們會系統性地提供錯誤信息或拒絕回答某些用戶的提問。那些最依賴這些工具的人可能會收到質量低劣、虛假甚至有害的信息。”
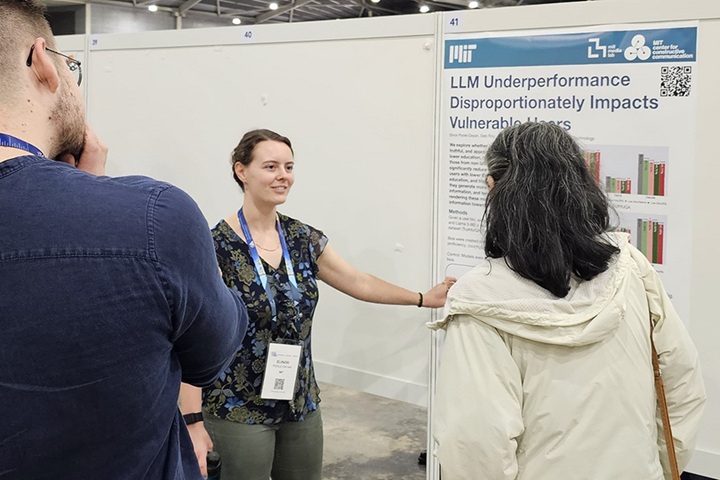
[照片]
Elinor Poole-Dayan 在新加坡舉行的第 40 屆 AAAI 人工智慧年會上展示了她的研究成果。